

做运维的人,大概都经历过这样的场面:
系统突然访问不了。
电话开始响了。
业务部门问:“什么时候恢复?”
领导问:“什么原因?”
技术人员一边查日志、一边看监控、一边登录服务器,折腾半天,终于找到问题。
服务恢复了。
大家松了一口气。
然后事故报告上写:
“经排查,由于某某服务异常导致系统无法访问,目前已重启服务,系统恢复正常。”
事情结束了吗?
其实远远没有。
因为对于真正严肃的生产系统来说,“恢复了”只能说明故障处理结束了,并不代表事故处理结束了。
为什么这个服务会异常?
为什么监控没有提前发现?
为什么异常能够发展成业务中断?
为什么没有冗余接管?
为什么以前没发现这个隐患?
其他服务器有没有一样的问题?
下一次还会不会发生?
如果这些问题没有答案,那么所谓“事故处理完成”,很可能只是:
这一次运气不错,把火灭了。
而在航天、军工、科研生产以及一些对可靠性要求非常高的行业里,有一套很经典的问题处理方法——
双五归零
很多做IT运维的人第一次听这个词,可能觉得它有点“质量管理”。
但仔细研究以后会发现:
这套方法其实特别适合IT故障复盘。
尤其适合服务器、网络、云平台、数据库、中间件、存储、安全设备以及重要业务系统的事故分析。
一、什么叫“双五归零”?
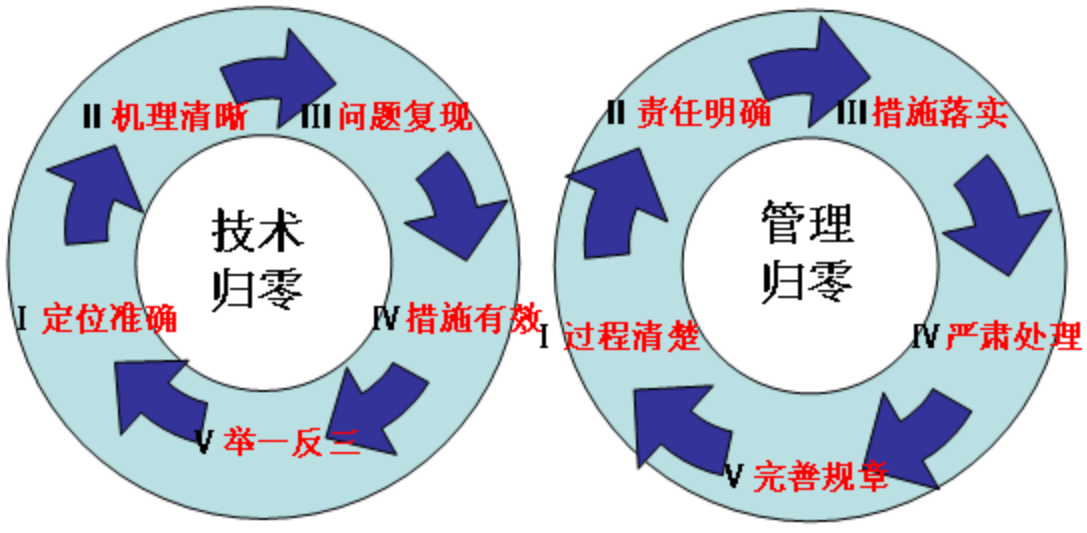
所谓“双五归零”,简单来说,就是一件质量问题或者事故发生以后,要从两条线彻底把问题处理干净:
技术归零 + 管理归零。
技术归零解决的是:
这个问题到底是怎么发生的?以后怎么保证技术上不再发生?
管理归零解决的是:
为什么我们的管理体系没有提前发现和阻止这个问题?以后怎么保证管理上不再放过?
两边各有五项要求。
技术归零:
定位准确、机理清楚、问题复现、措施有效、举一反三。
管理归零:
过程清楚、责任明确、措施落实、严肃处理、完善规章。
看起来只有20个字。
但如果真的按照这20个字把一次IT事故分析透,很多事故报告可能就不是一两页纸能解决的了。
二、第一个归零:定位准确
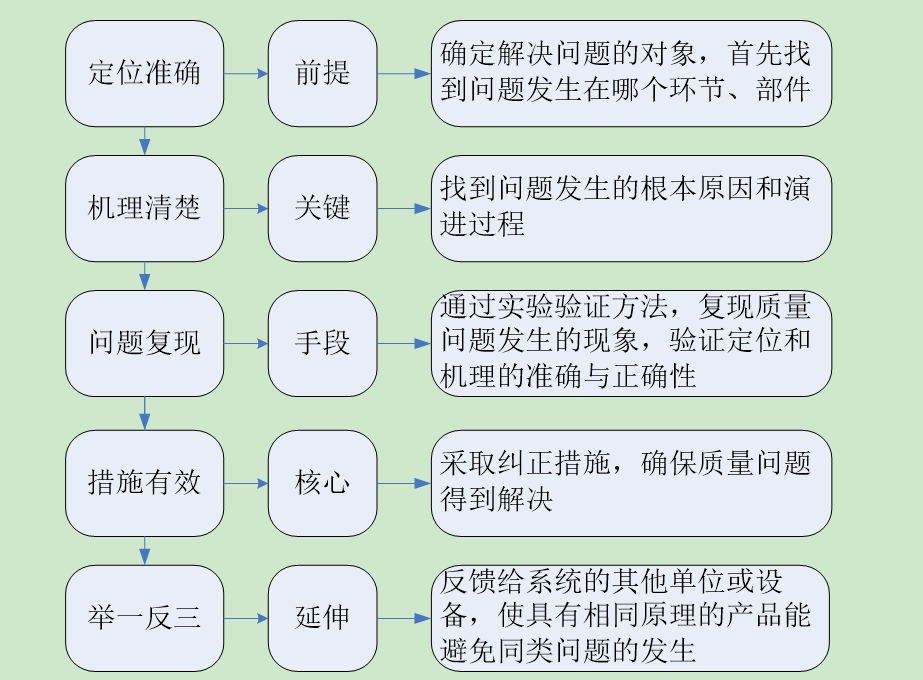
事故发生以后,技术人员最容易犯的一个错误,就是把“现象”当成“原因”。
比如:
“数据库连接失败。”
这是不是事故原因?
不是。
这只是现象。
“服务器CPU使用率100%。”
是不是原因?
也不一定。
还是现象。
甚至:
“Redis服务宕机。”
都不一定是真正的根因。
真正的“定位准确”,应该继续往下追。
为什么Redis宕机?
是内存耗尽?
为什么内存耗尽?
是业务访问量增加?
缓存策略有问题?
参数配置不合理?
程序存在内存泄漏?
宿主机资源争抢?
还是运维变更导致?
最终应该定位到一个能够解释整个故障链条的具体问题点。
例如:
某业务节点由于日志目录未配置容量限制,日志持续增长导致系统分区空间耗尽,进而造成数据库写入异常,最终导致应用服务不可用。
到这里,才开始接近“定位准确”。
所以事故分析里非常重要的一句话就是:
不要停留在故障现象,要继续寻找导致现象发生的根因。
三、第二个归零:机理清楚
找到问题点以后,还没完。
还要回答一个问题:
它为什么能够造成这么大的影响?
这就是“机理清楚”。
举个简单的例子。
某服务器磁盘满了。
如果事故报告只写:
因服务器磁盘空间不足导致业务异常。
其实是不够的。
完整的故障链可能是:
日志策略配置不合理
↓
日志持续增长
↓
磁盘使用率达到100%
↓
数据库无法正常写入
↓
应用事务失败
↓
接口大量超时
↓
前端业务无法访问
这条链路一旦画出来,问题性质就完全不同了。
因为你开始知道:
事故不是某一个时间点突然发生的,而是经过了一系列条件积累。
这对运维尤其重要。
因为很多重大故障,其实在真正爆发之前,系统已经发出了大量信号。
磁盘80%。
磁盘90%。
IO持续升高。
接口响应时间增加。
数据库连接数异常。
错误日志快速增长。
如果这些信号没有被监控发现,那么问题可能就不仅仅是“磁盘满了”。
还可能存在另外一个问题:
我们的监控体系失效了。
这就是“机理清楚”的价值。
它会逼着你从一个故障点,看到整条故障链。
四、第三个归零:问题复现
这是很多事故报告最容易省略的一步。
技术人员说:
“应该就是这个原因。”
领导问:
“确定吗?”
“基本确定。”
“能证明吗?”
沉默了。
所以技术归零里面有一个非常关键的要求:
问题复现。
也就是说,在条件允许的情况下,通过测试环境、日志分析、模拟测试等方式证明:
当条件A出现以后,确实能够导致现象B。
比如怀疑连接池配置导致服务异常。
那么可以在测试环境模拟并发访问,观察连接池耗尽以后是否能够复现同样的报错。
怀疑防火墙策略导致业务中断。
那么就应该结合策略变更记录、会话日志、流量日志和测试结果验证。
怀疑DNS异常。
就应该结合解析记录、缓存时间、请求日志和抓包结果验证。
为什么要这么麻烦?
因为事故复盘最怕一句话:
“根据经验判断。”
经验当然重要。
但事故定责、技术整改甚至后续系统架构调整,不能全部建立在经验猜测上。
日志、数据、测试、时间线和复现结果,才是真正站得住脚的证据。
五、第四个归零:措施有效
找到原因以后,下一步自然就是整改。
但这里又有一个常见问题:
整改不等于有效整改。
比如磁盘满了。
整改措施:
“删除日志,释放磁盘空间。”
有效吗?
短期有效。
一个月以后呢?
可能继续满。
真正的措施可能应该包括:
调整日志轮转策略;
设置日志保留周期;
配置磁盘容量阈值告警;
增加自动清理机制;
调整磁盘容量;
纳入日常巡检;
对同类型服务器统一修改。
然后还要验证。
例如:
人为制造磁盘达到告警阈值的场景,监控平台是否真的产生告警?
告警有没有发给正确的人?
收到告警以后有没有处置流程?
日志轮转是否真的执行?
超过保留周期的日志是否真的删除?
所以“措施有效”不是:
我已经改了。
而应该是:
我改了,而且验证过,确实能解决问题。
这两个概念差别非常大。
六、第五个归零:举一反三
这是我认为“双五归零”里面特别值得IT运维学习的一条。
假设今天一台Linux服务器因为日志没有轮转导致磁盘满了。
把这台服务器修好,算结束吗?
不算。
因为下一句话应该马上问:
其他服务器呢?
如果这台服务器存在这个配置问题,那么同一个批次部署的50台服务器有没有?
测试环境有没有?
生产环境有没有?
备份中心有没有?
其他业务系统有没有?
甚至还应该继续扩大范围:
有没有其他可能导致磁盘打满的目录?
数据库备份有没有清理?
Docker日志有没有限制?
临时文件有没有定期清理?
应用日志有没有统一规范?
这就是:
举一反三。
真正成熟的运维体系,不应该是:
发现一个坑,填一个坑。
而应该是:
发现一个坑以后,沿着这个坑把整个园区检查一遍。
七、技术问题解决了,为什么还要“管理归零”?
讲完技术归零以后,一个更麻烦的问题来了。
假设技术原因已经完全搞清楚了。
事故是不是结束了?
仍然不是。
因为还需要回答:
为什么我们的管理体系允许这个问题发生?
这就是第二个“五归零”——管理归零。
八、过程清楚:把整件事情还原出来
管理分析第一件事不是处罚谁。
而是先把事情搞清楚。
什么时候进行了操作?
谁进行了操作?
依据什么流程?
有没有审批?
什么时候第一次出现异常?
监控什么时候产生告警?
有没有人收到?
什么时候开始处置?
什么时候升级汇报?
什么时候恢复业务?
这时候,一张事故时间线往往比几千字说明更有用。
例如:
14:03 实施配置变更
14:07 出现异常
14:08 监控产生告警
14:15 运维人员开始排查
14:32 初步定位问题
14:45 实施恢复操作
14:53 业务恢复
16:20 完成原因确认
时间线一出来,很多管理问题自己就暴露出来了。
比如:
为什么14:08告警,14:15才有人处理?
为什么进行了变更却没有业务验证?
为什么恢复用了45分钟?
为什么没有快速回退?
这些都是下一步需要分析的问题。
九、责任明确:不是简单地找一个人背锅
事故复盘一说到“责任”,很多人第一反应就是:
找谁背锅?
其实这是对责任分析非常粗暴的理解。
真正有效的责任分析应该区分:
操作责任、审核责任、管理责任、监督责任、技术保障责任等。
比如一次配置错误造成业务中断。
表面上看:
“某工程师配置错了。”
但继续分析可能会发现:
变更没有双人复核;
没有测试环境验证;
没有配置备份;
没有自动校验工具;
没有回退方案;
审批流形同虚设;
监控也没有覆盖关键指标。
这时候你会发现:
事故往往不是一个人的一个错误,而是一串防线同时失效。
所以责任明确的真正意义,是搞清楚:
哪一道防线应该由谁负责,而这道防线为什么没有发挥作用。
十、措施落实:整改不能停留在Word里
这是很多事故报告最尴尬的地方。
整改措施写了十几条。
半年以后再看:
没几条真正落地。
所以管理归零强调的是:
措施落实。
每一项整改最好都能够回答几个问题:
谁负责?
什么时候完成?
完成标准是什么?
谁验收?
证据在哪里?
例如不能只写:
加强服务器巡检。
而应该写得更加具体:
将服务器系统盘使用率纳入统一监控,设置分级告警阈值,并由基础环境运维人员每日核查告警处置情况,于XX日前完成全部生产服务器覆盖。
这样才叫可以执行。
否则“加强管理、加强检查、提高意识、强化责任”这些话写了一页纸,可能什么都没改变。
十一、严肃处理:处理的目的不是为了“祭天”
出了事故以后,责任处理是必要的。
但真正有价值的处理,不应该停留在:
“某某写检查。”
“某某扣绩效。”
然后事情结束。
因为如果系统本身允许一个普通操作失误直接导致整个生产系统中断,那么即使换一个人操作,事故依然可能发生。
所以处理人的同时,更重要的是问:
为什么一个人的错误能够穿透所有防线?
成熟的系统应该尽可能做到:
一个人配置错了,还有审核。
审核漏了,还有自动检查。
自动检查漏了,还有监控。
监控发现以后,还有快速回退。
回退失败,还有高可用或者容灾。
这其实也是可靠性工程非常重要的一种思想:
不要假设人永远不会犯错,而要让系统具备容错能力。
十二、完善规章:最终把经验变成制度
一次事故真正有价值的地方,不只是把这一次的问题解决。
而是:
把这次踩过的坑,变成以后所有人的护栏。
例如一次网络变更事故以后,可以完善:
网络变更审批制度;
配置备份要求;
双人复核机制;
变更前检查清单;
变更后业务验证;
回退方案要求;
重大变更值守制度;
设备配置基线;
自动化配置检查。
一次服务器事故以后,可以完善:
服务器巡检制度;
容量管理制度;
账号权限管理;
备份恢复管理;
监控告警规范;
操作审计制度;
应急处置预案。
这才叫真正的:
归零。
不是问题消失了就叫归零。
而是从技术到管理,把导致问题发生的条件尽可能清掉,才叫归零。
十三、IT运维其实特别适合“双五归零”
如果把“双五归零”翻译成IT人的语言,其实特别容易理解。
一次故障发生以后,不妨连续问十个问题:
技术五问:
哪里坏了?
为什么坏?
能不能证明?
修复方案真的有效吗?
其他地方有没有一样的问题?
然后再问:
管理五问:
整个事情到底是怎么发生的?
每个环节应该由谁负责?
整改到底有没有落地?
相关责任怎么处理?
制度和流程应该怎么改?
这十个问题问完,一份真正有价值的事故报告基本就出来了。
十四、为什么很多事故总是在重复发生?
做运维时间久了,会发现一个很有意思的现象。
有些单位每年都在写事故报告。
甚至每年的问题都差不多。
磁盘满了。
证书过期。
密码过期。
链路中断。
数据库连接池耗尽。
配置误操作。
备份不可用。
监控没有告警。
设备维保过期没人知道。
账号密码找不到。
厂家联系人不知道是谁。
每次出了问题以后:
排查。
恢复。
写报告。
开会。
整改。
过几个月,又来一次。
为什么?
因为很多时候,我们完成的是:
故障恢复。
而不是:
问题归零。
这两件事看起来很像,实际上完全不同。
十五、真正成熟的运维,不应该靠“老师傅记得”
很多系统之所以能够稳定运行,并不是因为体系有多完善。
而是因为:
“老张知道这个设备怎么重启。”
“老李记得数据库密码。”
“这个系统一直是小王维护。”
“出了问题找厂家赵工。”
这种运维方式平时看起来没什么问题。
直到有一天:
老张休假了。
老李调走了。
小王离职了。
赵工换公司了。
事故突然就变得非常难处理。
所以“双五归零”最终推动的,其实是一件非常朴素的事情:
把个人经验变成组织能力。
把“我知道”变成台账。
把“我记得”变成文档。
把“出了问题再说”变成监控。
把“应该没问题”变成验证。
把“下次注意”变成制度。
把“找个人问问”变成明确的责任边界。
这才是运维体系真正成熟的标志。
写在最后
IT行业特别喜欢谈新技术。
云原生、微服务、容器、AI运维、自动化、可观测性、零信任……
这些当然重要。
但做运维久了会慢慢发现:
真正决定一个系统能不能长期稳定运行的,往往不是用了多少先进技术,而是出了问题以后,这个组织到底有没有能力把问题彻底搞明白。
系统恢复,只意味着这一次事故暂时结束。
事故归零,才意味着组织真正从这次事故里学到了东西。
所以以后再看到一句:
“故障已恢复,后续加强巡检。”
不妨继续追问一句:
真的归零了吗?
如果技术原因没有彻底搞清楚,问题没有验证,其他系统没有排查,责任边界没有明确,整改没有落实,制度也没有改变——
那么所谓“事故结束”,可能只是:
下一次事故的倒计时,又重新开始了。